標準差怎麼一步一步計算?
計算標準差時,先求出平均數,用每個數值減去平均數,再把每個差平方,然後把這些平方加起來。用這個總和除以數值的個數,就得到變異數。最後,求變異數的平方根。結果就是標準差,它的單位和原始資料相同。
例子
兩個各有8名隊員的隊伍作答同一份10題的測驗。來看B隊,他們的得分是2、4、4、4、5、5、7和9。
- 求平均數。2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40,40 ÷ 8 = 5
- 用每個數值減去平均數。得到−3、−1、−1、−1、0、0、2、4
- 把每個差平方。得到9、1、1、1、0、0、4、16
- 把平方加起來。9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- 除以數值的個數。32 ÷ 8 = 4,這就是變異數
- 求平方根。√4 = 2,所以標準差是2
把同樣的計算逐一寫出每個數值,比較容易看清楚。
- 2 − 5 = −3,(−3)² = 9
- 4 − 5 = −1,(−1)² = 1,共三次
- 5 − 5 = 0,0² = 0,共兩次
- 7 − 5 = 2,2² = 4
- 9 − 5 = 4,4² = 16
注意,這些差本身,也就是−3、−1、−1、−1、0、0、2和4,加起來等於0。這種情況一定會出現,它也解釋了為什麼要平方,下一節會詳細說明。最後一步需要開平方,多玩幾輪平方根,心算估計平方根會快很多。
標準差的公式是什麼?
母體標準差的公式是σ = √(Σ(x − μ)² ÷ N)。其中x是每個數值,μ是平均數,N是數值的個數,Σ表示「把它們全部加起來」。如果是從更大的群體中抽取的樣本,就除以n − 1而不是N。這種標準差記作s。
例子
如果B隊就是你關心的全部對象,就用N。變異數是32 ÷ 8 = 4,σ = √4 = 2。
如果這8名隊員是為了代表整個學校而選出的樣本,就用n − 1。變異數是32 ÷ 7 ≈ 4.57,s = √4.57 ≈ 2.14。
為什麼樣本要除以n − 1?
樣本通常會漏掉整個群體中一些最極端的數值,所以算出的分散程度往往偏小一點。除以稍小一點的數n − 1,會讓結果稍大一些,藉此修正這個偏差。樣本很大時,兩種算法的差別會變得很小。
計算機和試算表通常兩種算法都有。標有σ或「STDEV.P」的按鍵或函數除以N,標有s或「STDEV.S」的除以n − 1。先確認老師或課本要求用哪一種,因為兩種在各自的情況下都是正確的。
計算標準差時為什麼要把差平方?
與平均數的差加起來總是等於0,因為高於平均數的數值和低於平均數的數值剛好抵銷。平方會讓每個差都變成正數,這樣它們就不會再互相抵銷。最後開平方,又把結果變回原來的單位,所以分數的分散程度仍然以分為單位。
例子
B隊的差是−3、−1、−1、−1、0、0、2和4。它們的總和是0,所以直接求平均也是0,完全看不出分散程度。平方之後變成9、1、1、1、0、0、4和16,加起來是32。
平方還會讓離平均數遠的數值佔更大的比重。NIST Engineering Statistics Handbook對此有清楚的說明。離平均數2個單位的點給總和加上4,而離平均數10個單位的點則加上100。這使得標準差對單一極端值很敏感,例如在一個其他人都考得不錯的小組裡,有一個人得了0分。
還有一種更簡單的量,不需要平方。平均絕對離差取每個數值到平均數的距離,忽略負號,再求它們的平均數。以B隊來說,距離3、1、1、1、0、0、2和4加起來是12,12 ÷ 8 = 1.5。它比較容易用手算,但大多數統計工具和公式都是以標準差為基礎的。
標準差多大算大,多小算小?
沒有一個固定的數可以判斷標準差是大還是小。這取決於數值的大小和它們測量的是什麼。對滿分10分的測驗來說,2分的標準差很大,但對滿分1000分的成績來說就很小。要把它和平均數以及可能數值的範圍放在一起比較。
例子
現在把同一次測驗中的B隊和A隊比較一下。
- A隊:3、5、5、5、5、5、5、7
- B隊:2、4、4、4、5、5、7、9
兩個隊的平均數都是5,因為每組數加起來都是40,40 ÷ 8 = 5。但A隊的得分緊緊圍繞在5附近,而B隊的得分從2分散到9。A隊的標準差是1分,B隊的標準差是2分。
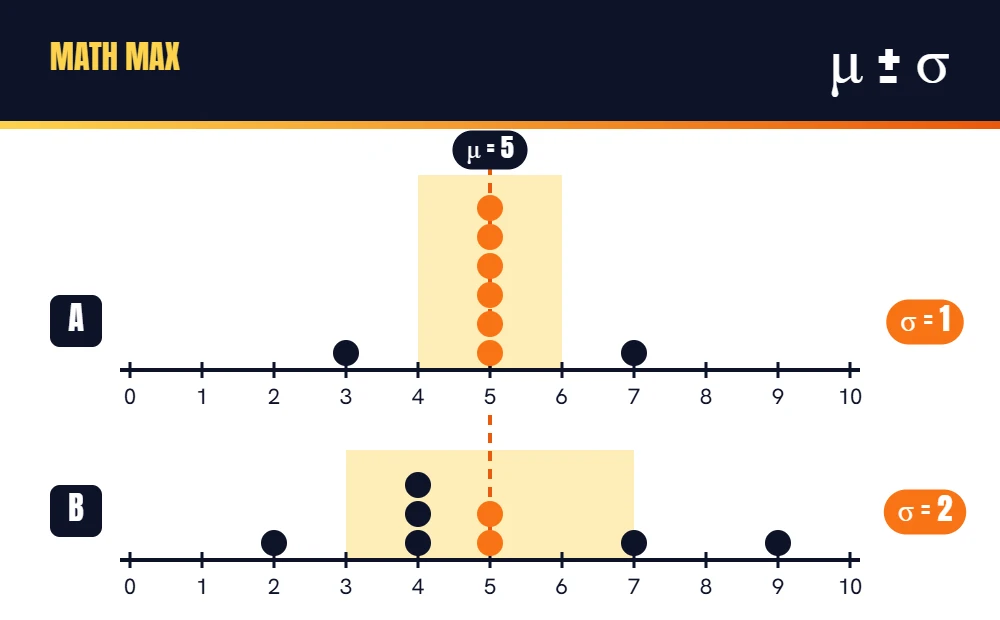
只看平均數,這兩個隊會顯得一模一樣。標準差則顯示,A隊的成績非常穩定,而B隊有些隊員遙遙領先,有些遠遠落後。
另一個例子
兩家麵包店賣的麵包平均重量都是500 g。第一家的標準差是5 g,所以幾乎每個麵包都接近500 g。第二家的標準差是40 g,所以有些麵包明顯輕一些,有些重一些。平均數一樣,但第一家麵包店穩定得多。
標準差小並不一定比較好。在課堂上,考試成績的標準差大,可能只是表示孩子們處在很不相同的階段,這對老師來說是有用的資訊。在工廠裡,標準差小通常代表機器運作可靠。這個數描述的是分散程度,而這種分散是不是好消息,要看實際情況。
標準差永遠不可能是負數,因為它來自平方數的平方根。只有當所有數值都相同時,標準差才是0。
68-95-99.7法則是什麼意思?
對於符合常態分布的資料,也就是我們熟悉的鐘形曲線,大約68%的數值落在平均數左右一個標準差的範圍內。大約95%落在兩個標準差以內,大約99.7%落在三個標準差以內。這叫作經驗法則,它能把一個標準差變成對資料的快速印象。
例子
假設在一個很大的群體中,1 km跑步的時間符合鐘形曲線,平均數是6分鐘,標準差是1分鐘。那麼大約68%的跑者會在5到7分鐘之間跑完。大約95%會在4到8分鐘之間跑完,幾乎所有人都會在3到9分鐘之間跑完。
這條法則只適用於鐘形分布的資料。像兩個測驗隊伍這樣的小群體,很少會嚴格符合它。對於偏斜的資料,例如收入或等待時間,平均數和標準差可能會給人誤導的印象,中位數和全距往往更能描述資料。
平均數是每個標準差的起點,所以能快速算出平均數很有幫助。在統計遊戲中,戰鬥裡的每次攻擊都是一道統計題,所以心算平均數就成了贏下一回合的一部分。短而頻繁的練習,比一次長時間的練習更能提升速度。
標準差就是到平均數的典型距離
標準差回答的是一個問題。一個典型的數值離平均數有多遠?需要用手算標準差時,就照下面的步驟來做。
- 求平均數。
- 用每個數值減去平均數。
- 把每個差平方。
- 把平方加起來。
- 如果是整個母體,就除以N;如果是樣本,就除以n − 1。
- 求平方根。
結果小,表示數值靠得很近;結果大,表示數值很分散。一定要搭配平均數和單位來解讀它,因為分散程度只有放在實際情境中才有意義。