标准差怎么一步一步计算?
计算标准差时,先求出平均数,用每个数值减去平均数,再把每个差平方,然后把这些平方加起来。用这个总和除以数值的个数,就得到方差。最后,求方差的平方根。结果就是标准差,它的单位和原始数据相同。
例子
两个各有8名队员的队伍回答同一份10道题的测验。来看B队,他们的得分是2、4、4、4、5、5、7和9。
- 求平均数。2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40,40 ÷ 8 = 5
- 用每个数值减去平均数。得到−3、−1、−1、−1、0、0、2、4
- 把每个差平方。得到9、1、1、1、0、0、4、16
- 把平方加起来。9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- 除以数值的个数。32 ÷ 8 = 4,这就是方差
- 求平方根。√4 = 2,所以标准差是2
把同样的计算逐个数值写出来,更容易看清楚。
- 2 − 5 = −3,(−3)² = 9
- 4 − 5 = −1,(−1)² = 1,共三次
- 5 − 5 = 0,0² = 0,共两次
- 7 − 5 = 2,2² = 4
- 9 − 5 = 4,4² = 16
注意,这些差本身,也就是−3、−1、−1、−1、0、0、2和4,加起来等于0。这种情况总会出现,它也解释了为什么要平方,下一节会具体说明。最后一步需要开平方,多玩几轮平方根,心算估计平方根会快得多。
标准差的公式是什么?
总体标准差的公式是σ = √(Σ(x − μ)² ÷ N)。其中x是每个数值,μ是平均数,N是数值的个数,Σ表示“把它们全部加起来”。如果是从更大的群体中抽取的样本,就除以n − 1而不是N。这种标准差记作s。
例子
如果B队就是你关心的全部对象,就用N。方差是32 ÷ 8 = 4,σ = √4 = 2。
如果这8名队员是为了代表整个学校而选出的样本,就用n − 1。方差是32 ÷ 7 ≈ 4.57,s = √4.57 ≈ 2.14。
为什么样本要除以n − 1?
样本通常会漏掉整个群体中一些最极端的数值,所以算出的离散程度往往偏小一点。除以稍小一点的数n − 1,会让结果稍大一些,从而修正这个偏差。样本很大时,两种算法的差别会变得很小。
计算器和电子表格通常两种算法都提供。标有σ或“STDEV.P”的按键或函数除以N,标有s或“STDEV.S”的除以n − 1。先确认老师或课本要求用哪一种,因为两种在各自的情况下都是正确的。
计算标准差时为什么要把差平方?
与平均数的差加起来总是等于0,因为高于平均数的数值和低于平均数的数值正好抵消。平方会让每个差都变成正数,这样它们就不会再相互抵消。最后开平方,又把结果变回原来的单位,所以分数的离散程度仍然以分为单位。
例子
B队的差是−3、−1、−1、−1、0、0、2和4。它们的总和是0,所以直接求平均也是0,完全看不出离散程度。平方之后变成9、1、1、1、0、0、4和16,加起来是32。
平方还会让离平均数远的数值占更大的比重。NIST Engineering Statistics Handbook对此有清楚的说明。离平均数2个单位的点给总和加上4,而离平均数10个单位的点则加上100。这使得标准差对单个极端值很敏感,比如在一个其他人都考得不错的小组里,有一个人得了0分。
还有一种更简单的量,不需要平方。平均绝对偏差取每个数值到平均数的距离,忽略负号,再求它们的平均数。对B队来说,距离3、1、1、1、0、0、2和4加起来是12,12 ÷ 8 = 1.5。它更容易手算,但大多数统计工具和公式都是以标准差为基础的。
标准差多大算大,多小算小?
没有一个固定的数可以判断标准差是大还是小。这取决于数值的大小和它们测量的是什么。对满分10分的测验来说,2分的标准差很大,但对满分1000分的成绩来说就很小。要把它和平均数以及可能取值的范围放在一起比较。
例子
现在把同一次测验中的B队和A队比较一下。
- A队:3、5、5、5、5、5、5、7
- B队:2、4、4、4、5、5、7、9
两个队的平均数都是5,因为每组数加起来都是40,40 ÷ 8 = 5。但A队的得分紧紧围绕在5附近,而B队的得分从2分散到9。A队的标准差是1分,B队的标准差是2分。
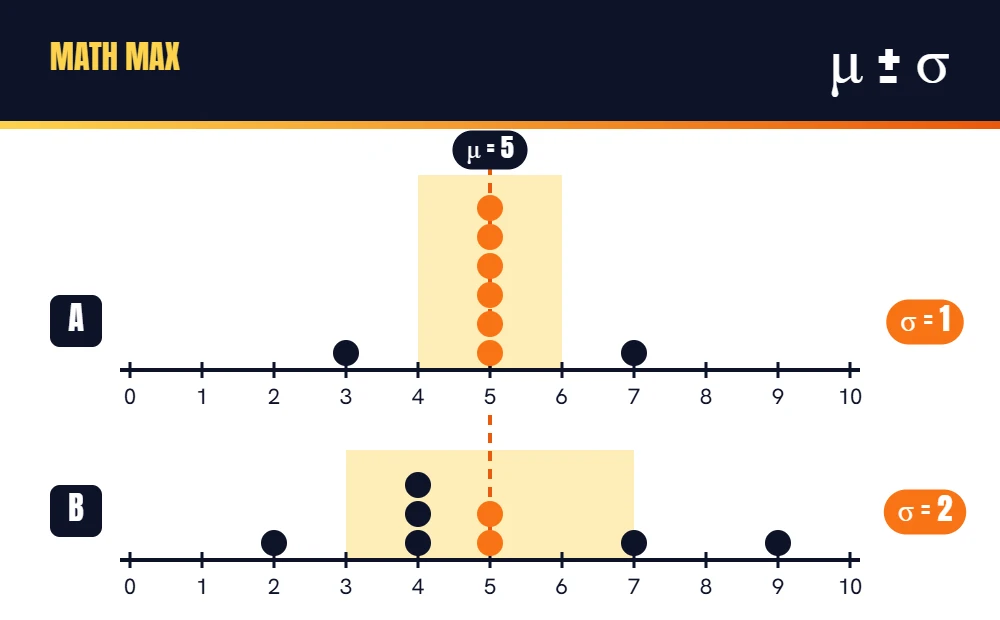
只看平均数,这两个队会显得一模一样。标准差则显示,A队的成绩非常稳定,而B队有些队员遥遥领先,有些远远落后。
另一个例子
两家面包店卖的面包平均重量都是500 g。第一家的标准差是5 g,所以几乎每个面包都接近500 g。第二家的标准差是40 g,所以有些面包明显轻一些,有些重一些。平均数一样,但第一家面包店稳定得多。
标准差小并不总是更好。在课堂上,考试成绩的标准差大,可能只是说明孩子们处在很不相同的阶段,这对老师来说是有用的信息。在工厂里,标准差小通常意味着机器运转可靠。这个数描述的是离散程度,而这种离散是不是好消息,要看具体情况。
标准差永远不可能是负数,因为它来自平方数的平方根。只有当所有数值都相同时,标准差才是0。
68-95-99.7法则是什么意思?
对于服从正态分布的数据,也就是我们熟悉的钟形曲线,大约68%的数值落在平均数左右一个标准差的范围内。大约95%落在两个标准差以内,大约99.7%落在三个标准差以内。这叫作经验法则,它能把一个标准差变成对数据的快速印象。
例子
假设在一个很大的群体中,1 km跑的用时服从钟形曲线,平均数是6分钟,标准差是1分钟。那么大约68%的跑步者会在5到7分钟之间跑完。大约95%会在4到8分钟之间跑完,几乎所有人都会在3到9分钟之间跑完。
这条法则只适用于钟形分布的数据。像两个测验队伍这样的小群体,很少会严格符合它。对于偏斜的数据,比如收入或等待时间,平均数和标准差可能会给人误导的印象,中位数和极差往往能更好地描述数据。
平均数是每个标准差的起点,所以能快速算出平均数很有帮助。在统计游戏中,战斗里的每次攻击都是一道统计题,所以心算平均数就成了赢下一回合的一部分。短而频繁的练习,比一次长时间的练习更能提高速度。
标准差就是到平均数的典型距离
标准差回答的是一个问题。一个典型的数值离平均数有多远?需要手算标准差时,就按下面的步骤来。
- 求平均数。
- 用每个数值减去平均数。
- 把每个差平方。
- 把平方加起来。
- 如果是整个总体,就除以N;如果是样本,就除以n − 1。
- 求平方根。
结果小,说明数值靠得很近;结果大,说明数值很分散。一定要结合平均数和单位来解读它,因为离散程度只有放在具体情境中才有意义。