Hoe bereken je de standaarddeviatie stap voor stap?
Om de standaarddeviatie te berekenen, zoek je het gemiddelde, trek je dat af van elke waarde, kwadrateer je elk verschil en tel je de kwadraten op. Deel dat totaal door het aantal waarden, dan krijg je de variantie. Neem ten slotte de wortel van de variantie. Het resultaat is de standaarddeviatie, weer in de oorspronkelijke eenheid van de gegevens.
Voorbeeld
Twee teams van 8 spelers maken dezelfde quiz met 10 vragen. Neem team B, met de scores 2, 4, 4, 4, 5, 5, 7 en 9.
- Zoek het gemiddelde. 2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40, en 40 : 8 = 5
- Trek het gemiddelde af van elke waarde. Dat geeft −3, −1, −1, −1, 0, 0, 2, 4
- Kwadrateer elk verschil. Dat geeft 9, 1, 1, 1, 0, 0, 4, 16
- Tel de kwadraten op. 9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- Deel door het aantal waarden. 32 : 8 = 4, dat is de variantie
- Neem de wortel. √4 = 2, dus de standaarddeviatie is 2
Dezelfde berekening, waarde voor waarde, maakt het makkelijker om het overzicht te houden.
- 2 − 5 = −3, en (−3)² = 9
- 4 − 5 = −1, en (−1)² = 1, drie keer
- 5 − 5 = 0, en 0² = 0, twee keer
- 7 − 5 = 2, en 2² = 4
- 9 − 5 = 4, en 4² = 16
Merk op dat de verschillen zelf, −3, −1, −1, −1, 0, 0, 2 en 4, samen 0 zijn. Dat is altijd zo, en het verklaart de stap met het kwadrateren, zoals het volgende deel laat zien. De laatste stap vraagt om een wortel, en een paar rondes wortels helpen je om die veel sneller uit je hoofd te schatten.
Wat is de formule voor de standaarddeviatie?
De standaarddeviatie van een populatie is σ = √(Σ(x − μ)² : N). Hierbij is x elke waarde, μ het gemiddelde, N het aantal waarden, en Σ betekent "tel alles op". Voor een steekproef uit een grotere groep deel je door n − 1 in plaats van door N. Die versie schrijf je als s.
Voorbeeld
Als team B de hele groep is waar het je om gaat, gebruik je N. De variantie is 32 : 8 = 4, en σ = √4 = 2.
Als de 8 spelers een steekproef zijn die een hele school moet vertegenwoordigen, gebruik je n − 1. De variantie is 32 : 7 ≈ 4,57, en s = √4,57 ≈ 2,14.
Waarom deel je bij een steekproef door n − 1?
In een steekproef ontbreken meestal een paar van de meest extreme waarden uit de hele groep, waardoor de spreiding vaak iets te klein uitvalt. Delen door n − 1, een iets kleiner getal, maakt de uitkomst iets groter en corrigeert dat. Bij grote steekproeven wordt het verschil tussen de twee versies heel klein.
Rekenmachines en spreadsheets bieden vaak beide versies. Een knop of functie met σ of "populatie" deelt door N, en een met s of "steekproef" deelt door n − 1. Controleer welke je leraar of je lesboek verwacht, want allebei zijn ze juist in hun eigen situatie.
Waarom kwadrateer je de verschillen bij de standaarddeviatie?
De verschillen met het gemiddelde zijn samen altijd nul, omdat de waarden boven het gemiddelde de waarden eronder in evenwicht houden. Door te kwadrateren wordt elk verschil positief, zodat ze elkaar niet meer opheffen. De wortel aan het eind brengt de uitkomst daarna terug naar de oorspronkelijke eenheid, dus een spreiding in punten meet je in punten.
Voorbeeld
Bij team B waren de verschillen −3, −1, −1, −1, 0, 0, 2 en 4. Hun totaal is 0, dus hun gewone gemiddelde is ook 0, en dat zegt niets over de spreiding. Na het kwadrateren worden ze 9, 1, 1, 1, 0, 0, 4 en 16, samen 32.
Kwadrateren geeft waarden die ver weg liggen ook meer gewicht. Het NIST Engineering Statistics Handbook laat dat duidelijk zien. Een punt op 2 eenheden van het gemiddelde voegt 4 toe aan het totaal, terwijl een punt op 10 eenheden afstand 100 toevoegt. Daardoor is de standaarddeviatie gevoelig voor één extreme waarde, zoals één score van 0 in een groep die verder goed scoorde.
Er is een eenvoudigere maat die het kwadrateren overslaat. De gemiddelde absolute afwijking neemt de afstand van elke waarde tot het gemiddelde, negeert de mintekens en neemt daar het gemiddelde van. Bij team B zijn de afstanden 3, 1, 1, 1, 0, 0, 2 en 4 samen 12, en 12 : 8 = 1,5. Die is makkelijker met de hand te berekenen, maar de standaarddeviatie is de maat waar de meeste statistische hulpmiddelen en formules op voortbouwen.
Wanneer is een standaarddeviatie hoog of laag?
Er is geen vast getal dat telt als een hoge of lage standaarddeviatie. Het hangt af van de grootte van de waarden en van wat ze meten. Een standaarddeviatie van 2 punten is groot bij quizscores op 10, maar heel klein bij scores op 1.000. Vergelijk die met het gemiddelde en met het bereik van de mogelijke waarden.
Voorbeeld
Vergelijk nu team B met team A uit dezelfde quiz.
- Team A: 3, 5, 5, 5, 5, 5, 5, 7
- Team B: 2, 4, 4, 4, 5, 5, 7, 9
Beide teams hebben een gemiddelde van 5, omdat elke lijst samen 40 is en 40 : 8 = 5. Maar de scores van team A liggen dicht rond 5, terwijl die van team B verspreid liggen van 2 tot 9. De standaarddeviatie van team A is 1 punt, die van team B 2 punten.
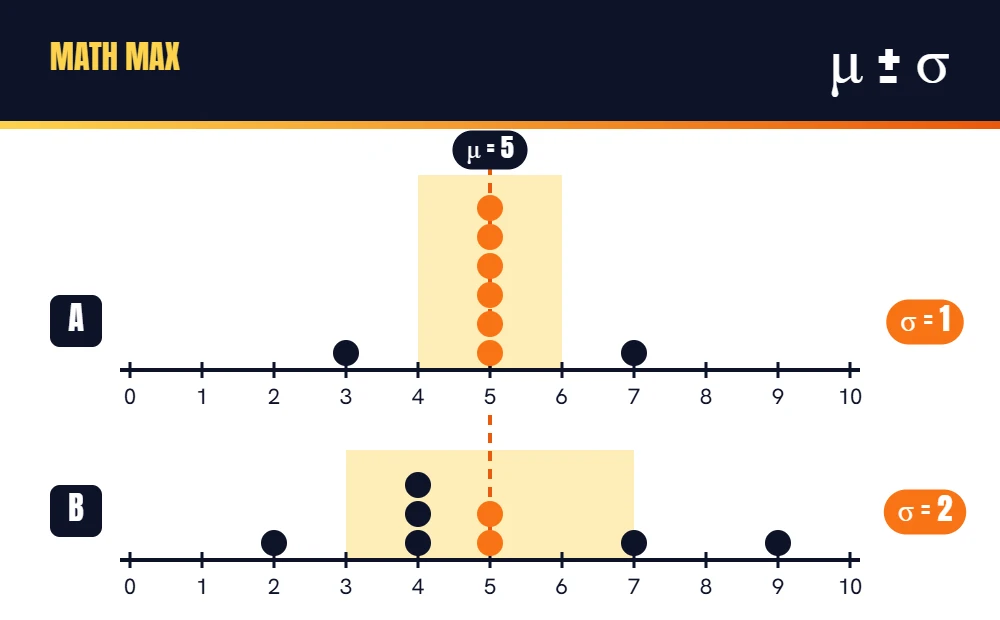
Op basis van alleen het gemiddelde zouden deze teams precies hetzelfde lijken. De standaarddeviatie laat zien dat team A heel constant is, terwijl team B een paar spelers heeft die ver voorliggen en een paar die ver achterliggen.
Nog een voorbeeld
Twee bakkerijen verkopen allebei broden met een gemiddeld gewicht van 500 g. Bij de eerste is de standaarddeviatie 5 g, dus bijna elk brood weegt ongeveer 500 g. Bij de tweede is die 40 g, dus sommige broden zijn duidelijk lichter en andere zwaarder. De gemiddelden zijn gelijk, maar de eerste bakkerij is veel constanter.
Een lage standaarddeviatie is niet altijd beter. In een klas kan een hoge standaarddeviatie in toetsresultaten gewoon laten zien dat kinderen heel verschillend ver zijn, en dat is nuttig voor een leraar om te weten. In een fabriek betekent een lage standaarddeviatie meestal dat de machines betrouwbaar zijn. Het getal beschrijft de spreiding, en de context bepaalt of die spreiding goed nieuws is.
Een standaarddeviatie kan nooit negatief zijn, omdat ze uit de wortel van gekwadrateerde getallen komt. Ze is alleen 0 als alle waarden gelijk zijn.
Wat betekent de 68-95-99,7-regel?
Bij gegevens die een normale verdeling volgen, de bekende klokvorm, ligt ongeveer 68% van de waarden binnen één standaarddeviatie van het gemiddelde. Ongeveer 95% ligt binnen twee standaarddeviaties, en ongeveer 99,7% binnen drie. Dit heet de empirische regel, en die maakt van een standaarddeviatie een snel beeld van de gegevens.
Voorbeeld
Stel dat de tijden voor een loop van 1 km in een grote groep een klokvorm volgen met een gemiddelde van 6 minuten en een standaarddeviatie van 1 minuut. Dan finisht ongeveer 68% van de lopers tussen 5 en 7 minuten. Ongeveer 95% finisht tussen 4 en 8 minuten, en bijna iedereen tussen 3 en 9 minuten.
De regel werkt alleen goed bij klokvormige gegevens. Kleine groepen, zoals de twee quizteams, volgen hem zelden precies. Bij scheve gegevens, zoals inkomens of wachttijden, kunnen het gemiddelde en de standaarddeviatie een misleidend beeld geven, en beschrijven de mediaan en het bereik de gegevens vaak beter.
Het gemiddelde is het beginpunt van elke standaarddeviatie, dus het helpt om gemiddelden snel uit te rekenen. In het statistiekspel is elke aanval in een gevecht een statistiekvraag, dus een gemiddelde uit je hoofd vinden wordt een deel van het winnen van een ronde. Korte, regelmatige rondes bouwen die snelheid beter op dan één lange sessie.
De standaarddeviatie is de typische afstand tot het gemiddelde
De standaarddeviatie beantwoordt één vraag. Hoe ver van het gemiddelde ligt een typische waarde? Gebruik deze stappen als je haar met de hand moet berekenen.
- Zoek het gemiddelde.
- Trek het gemiddelde af van elke waarde.
- Kwadrateer elk verschil.
- Tel de kwadraten op.
- Deel door N voor een hele populatie, of door n − 1 voor een steekproef.
- Neem de wortel.
Een kleine uitkomst betekent dat de waarden dicht bij elkaar liggen, en een grote uitkomst dat ze verspreid liggen. Lees haar altijd samen met het gemiddelde en de eenheid, want een spreiding heeft alleen betekenis in context.
Train hierna verder