Hvordan beregner du standardafvigelsen trin for trin?
For at beregne standardafvigelsen finder du gennemsnittet, trækker det fra hver værdi, sætter hver forskel i anden og lægger kvadraterne sammen. Divider summen med antallet af værdier, så får du variansen. Til sidst tager du kvadratroden af variansen. Resultatet er standardafvigelsen, igen i dataenes oprindelige enhed.
Eksempel
To hold med 8 spillere svarer på den samme quiz med 10 spørgsmål. Tag hold B, hvis point er 2, 4, 4, 4, 5, 5, 7 og 9.
- Find gennemsnittet. 2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40, og 40 : 8 = 5
- Træk gennemsnittet fra hver værdi. Det giver −3, −1, −1, −1, 0, 0, 2, 4
- Sæt hver forskel i anden. Det giver 9, 1, 1, 1, 0, 0, 4, 16
- Læg kvadraterne sammen. 9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- Divider med antallet af værdier. 32 : 8 = 4, som er variansen
- Tag kvadratroden. √4 = 2, så standardafvigelsen er 2
Den samme udregning, værdi for værdi, gør det lettere at holde styr på det.
- 2 − 5 = −3, og (−3)² = 9
- 4 − 5 = −1, og (−1)² = 1, tre gange
- 5 − 5 = 0, og 0² = 0, to gange
- 7 − 5 = 2, og 2² = 4
- 9 − 5 = 4, og 4² = 16
Læg mærke til, at selve forskellene, −3, −1, −1, −1, 0, 0, 2 og 4, giver 0 tilsammen. Det sker altid, og det forklarer, hvorfor man sætter i anden, som næste afsnit viser. Det sidste trin kræver en kvadratrod, og et par runder med kvadratrødder gør det meget hurtigere at skønne dem i hovedet.
Hvad er formlen for standardafvigelse?
Standardafvigelsen for en population er σ = √(Σ(x − μ)² : N). Her er x hver værdi, μ er gennemsnittet, N er antallet af værdier, og Σ betyder "læg det hele sammen". For en stikprøve fra en større gruppe dividerer du med n − 1 i stedet for N. Den version skrives s.
Eksempel
Hvis hold B er hele den gruppe, du interesserer dig for, bruger du N. Variansen er 32 : 8 = 4, og σ = √4 = 2.
Hvis de 8 spillere er en stikprøve, der skal repræsentere en hel skole, bruger du n − 1. Variansen er 32 : 7 ≈ 4,57, og s = √4,57 ≈ 2,14.
Hvorfor dividerer man med n − 1 for en stikprøve?
En stikprøve mangler som regel nogle af de mest ekstreme værdier i hele gruppen, så dens spredning har tendens til at blive lidt for lille. Når du dividerer med n − 1, et lidt mindre tal, bliver resultatet lidt større, og det retter op på det. Med store stikprøver bliver forskellen mellem de to versioner meget lille.
Lommeregnere og regneark tilbyder ofte begge versioner. En knap eller funktion mærket σ eller "population" dividerer med N, og en mærket s eller "stikprøve" dividerer med n − 1. Tjek, hvilken din lærer eller lærebog forventer, for begge er rigtige i deres egen situation.
Hvorfor sætter man forskellene i anden i standardafvigelsen?
Afvigelserne fra gennemsnittet giver altid nul tilsammen, fordi værdierne over gennemsnittet opvejer værdierne under. Når du sætter i anden, bliver hver forskel positiv, så de ikke længere ophæver hinanden. Kvadratroden til sidst bringer så resultatet tilbage til den oprindelige enhed, så en spredning i point måles i point.
Eksempel
For hold B var forskellene −3, −1, −1, −1, 0, 0, 2 og 4. Deres sum er 0, så deres almindelige gennemsnit er også 0, og det siger intet om spredningen. Sat i anden bliver de 9, 1, 1, 1, 0, 0, 4 og 16, som giver 32 tilsammen.
At sætte i anden giver også værdier langt væk mere vægt. NIST Engineering Statistics Handbook viser det tydeligt. Et punkt 2 enheder fra gennemsnittet lægger 4 til summen, mens et punkt 10 enheder væk lægger 100 til. Derfor er standardafvigelsen følsom over for en enkelt ekstrem værdi, som en enkelt score på 0 i en gruppe, der ellers klarede sig godt.
Der findes et enklere mål, som springer kvadreringen over. Den gennemsnitlige absolutte afvigelse tager afstanden fra hver værdi til gennemsnittet, ser bort fra minustegnene og finder gennemsnittet af dem. For hold B giver afstandene 3, 1, 1, 1, 0, 0, 2 og 4 tilsammen 12, og 12 : 8 = 1,5. Den er lettere at regne i hånden, men standardafvigelsen er det mål, som de fleste statistikværktøjer og formler bygger på.
Hvornår er en standardafvigelse høj eller lav?
Der er ikke ét bestemt tal, der gælder som en høj eller lav standardafvigelse. Det afhænger af værdiernes størrelse, og af hvad de måler. En standardafvigelse på 2 point er stor for quizresultater ud af 10, men meget lille for resultater ud af 1.000. Sammenlign den med gennemsnittet og med variationsbredden af de mulige værdier.
Eksempel
Sammenlign nu hold B med hold A fra den samme quiz.
- Hold A: 3, 5, 5, 5, 5, 5, 5, 7
- Hold B: 2, 4, 4, 4, 5, 5, 7, 9
Begge hold har et gennemsnit på 5, fordi hver liste giver 40 tilsammen, og 40 : 8 = 5. Men hold A's point samler sig omkring 5, mens hold B's er spredt fra 2 til 9. Hold A's standardafvigelse er 1 point, og hold B's er 2 point.
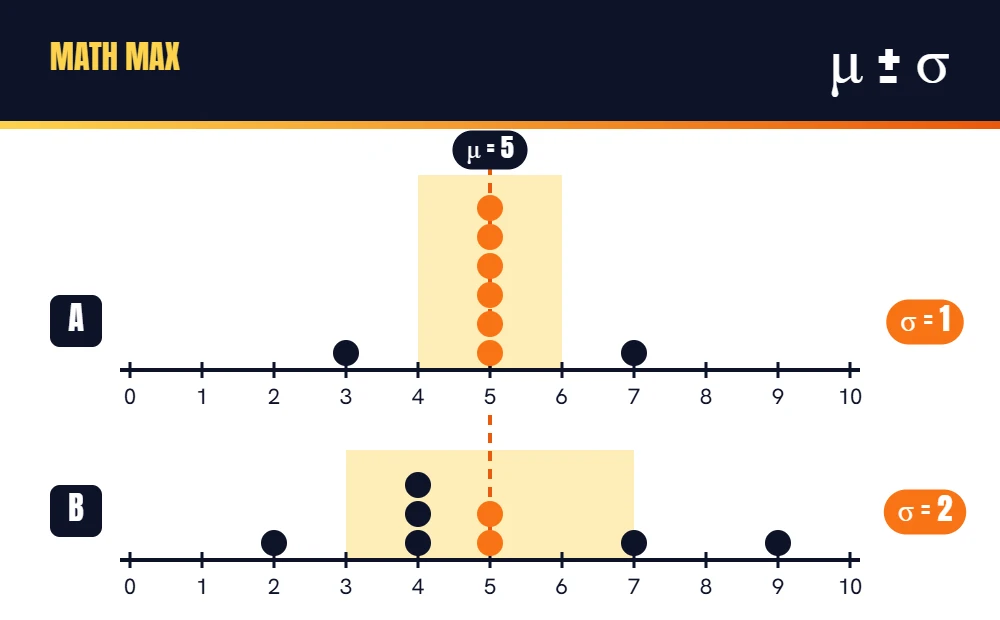
Ud fra gennemsnittet alene ville de to hold se ens ud. Standardafvigelsen viser, at hold A er meget stabilt, mens hold B har nogle spillere langt foran og nogle langt bagud.
Endnu et eksempel
To bagerier sælger begge brød med en gennemsnitlig vægt på 500 g. Hos det første er standardafvigelsen 5 g, så næsten hvert brød vejer tæt på 500 g. Hos det andet er den 40 g, så nogle brød er tydeligt lettere og nogle tungere. Gennemsnittene er ens, men det første bageri er langt mere stabilt.
En lav standardafvigelse er ikke altid bedre. I en klasse kan en høj standardafvigelse i testresultater blot vise, at børnene er meget forskellige steder, og det er nyttigt for en lærer at vide. På en fabrik betyder en lav standardafvigelse som regel, at maskinerne er pålidelige. Tallet beskriver spredningen, og sammenhængen afgør, om spredningen er gode nyheder.
En standardafvigelse kan aldrig være negativ, fordi den kommer fra en kvadratrod af tal sat i anden. Den er kun 0, når alle værdier er ens.
Hvad betyder 68-95-99,7-reglen?
For data, der følger en normalfordeling, den velkendte klokkeformede kurve, ligger omkring 68 % af værdierne inden for én standardafvigelse fra gennemsnittet. Omkring 95 % ligger inden for to standardafvigelser, og omkring 99,7 % inden for tre. Det kaldes den empiriske regel, og den gør en standardafvigelse til et hurtigt billede af dataene.
Eksempel
Forestil dig, at tiderne for et løb på 1 km i en stor gruppe følger en klokkekurve med et gennemsnit på 6 minutter og en standardafvigelse på 1 minut. Så kommer omkring 68 % af løberne i mål mellem 5 og 7 minutter. Omkring 95 % kommer i mål mellem 4 og 8 minutter, og næsten alle mellem 3 og 9 minutter.
Reglen virker kun godt for klokkeformede data. Små grupper, som de to quizhold, følger den sjældent tæt. For skæve data, som indkomster eller ventetider, kan gennemsnit og standardafvigelse give et misvisende billede, og medianen og variationsbredden beskriver ofte dataene bedre.
Gennemsnittet er udgangspunktet for enhver standardafvigelse, så det hjælper at kunne regne gennemsnit hurtigt ud. I statistikspillet er hvert angreb i en kamp et statistikspørgsmål, så det at finde et gennemsnit i hovedet bliver en del af at vinde en runde. Korte, hyppige runder opbygger den fart bedre end én lang træning.
Standardafvigelsen er den typiske afstand til gennemsnittet
Standardafvigelsen svarer på ét spørgsmål. Hvor langt fra gennemsnittet ligger en typisk værdi? Brug disse trin, når du skal finde den i hånden.
- Find gennemsnittet.
- Træk gennemsnittet fra hver værdi.
- Sæt hver forskel i anden.
- Læg kvadraterne sammen.
- Divider med N for en hel population eller med n − 1 for en stikprøve.
- Tag kvadratroden.
Et lille resultat betyder, at værdierne ligger tæt sammen, og et stort resultat betyder, at de er spredt ud. Læs det altid sammen med gennemsnittet og enheden, for en spredning giver kun mening i sin sammenhæng.
Træn disse herefter