Bagaimana cara menghitung standar deviasi langkah demi langkah?
Untuk menghitung standar deviasi, cari rata-ratanya, kurangkan rata-rata dari setiap nilai, kuadratkan setiap selisih, lalu jumlahkan kuadrat-kuadrat itu. Bagi jumlah tersebut dengan banyaknya nilai, dan hasilnya adalah ragam atau varians. Terakhir, tarik akar kuadrat dari varians. Hasilnya adalah standar deviasi, kembali dalam satuan asli datanya.
Contoh
Dua tim yang masing-masing terdiri dari 8 pemain mengerjakan kuis yang sama dengan 10 soal. Ambil Tim B, yang skornya 2, 4, 4, 4, 5, 5, 7, dan 9.
- Cari rata-ratanya. 2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40, dan 40 : 8 = 5
- Kurangkan rata-rata dari setiap nilai. Hasilnya −3, −1, −1, −1, 0, 0, 2, 4
- Kuadratkan setiap selisih. Hasilnya 9, 1, 1, 1, 0, 0, 4, 16
- Jumlahkan kuadratnya. 9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- Bagi dengan banyaknya nilai. 32 : 8 = 4, dan inilah variansnya
- Tarik akar kuadratnya. √4 = 2, jadi standar deviasinya 2
Perhitungan yang sama, nilai demi nilai, membuatnya lebih mudah diikuti.
- 2 − 5 = −3, dan (−3)² = 9
- 4 − 5 = −1, dan (−1)² = 1, sebanyak tiga kali
- 5 − 5 = 0, dan 0² = 0, sebanyak dua kali
- 7 − 5 = 2, dan 2² = 4
- 9 − 5 = 4, dan 4² = 16
Perhatikan bahwa selisih-selisih itu sendiri, −3, −1, −1, −1, 0, 0, 2, dan 4, jumlahnya 0. Hal ini selalu terjadi, dan inilah alasan langkah pengkuadratan, seperti yang ditunjukkan bagian berikutnya. Langkah terakhir memerlukan akar kuadrat, dan beberapa ronde latihan akar kuadrat membuatmu jauh lebih cepat menaksirnya di kepala.
Apa rumus standar deviasi?
Standar deviasi populasi adalah σ = √(Σ(x − μ)² : N). Di sini x adalah setiap nilai, μ adalah rata-rata, N adalah banyaknya nilai, dan Σ berarti "jumlahkan semuanya". Untuk sampel yang diambil dari kelompok yang lebih besar, bagilah dengan n − 1, bukan N. Versi itu ditulis s.
Contoh
Jika Tim B adalah seluruh kelompok yang ingin kamu ketahui, gunakan N. Variansnya 32 : 8 = 4, dan σ = √4 = 2.
Jika 8 pemain itu adalah sampel yang dipilih untuk mewakili seluruh sekolah, gunakan n − 1. Variansnya 32 : 7 ≈ 4,57, dan s = √4,57 ≈ 2,14.
Mengapa sampel dibagi dengan n − 1?
Sampel biasanya melewatkan sebagian nilai paling ekstrem dalam kelompok penuh, sehingga sebarannya cenderung sedikit terlalu kecil. Membagi dengan n − 1, bilangan yang sedikit lebih kecil, membuat hasilnya sedikit lebih besar dan mengoreksi hal itu. Pada sampel besar, perbedaan kedua versi menjadi sangat kecil.
Kalkulator dan spreadsheet sering menyediakan kedua versi. Tombol atau fungsi bertanda σ atau "STDEV.P" membagi dengan N, sedangkan yang bertanda s atau "STDEV.S" membagi dengan n − 1. Periksa mana yang diharapkan guru atau buku pelajaranmu, karena keduanya benar dalam situasinya masing-masing.
Mengapa selisih dikuadratkan dalam standar deviasi?
Selisih dari rata-rata selalu berjumlah nol, karena nilai di atas rata-rata mengimbangi nilai di bawahnya. Pengkuadratan membuat setiap selisih menjadi positif, sehingga tidak lagi saling meniadakan. Akar kuadrat di akhir lalu mengembalikan hasilnya ke satuan asli, jadi sebaran dalam poin diukur dalam poin.
Contoh
Untuk Tim B, selisihnya adalah −3, −1, −1, −1, 0, 0, 2, dan 4. Jumlahnya 0, jadi rata-rata biasanya juga 0, dan itu tidak mengatakan apa pun tentang sebaran. Setelah dikuadratkan, selisih itu menjadi 9, 1, 1, 1, 0, 0, 4, dan 16, yang jumlahnya 32.
Pengkuadratan juga memberi bobot lebih pada nilai yang jauh. NIST Engineering Statistics Handbook memberikan gambaran yang jelas. Titik yang berjarak 2 satuan dari rata-rata menambah 4 ke jumlah, sedangkan titik yang berjarak 10 satuan menambah 100. Karena itu standar deviasi peka terhadap satu nilai ekstrem, misalnya satu skor 0 dalam kelompok yang selebihnya mendapat nilai bagus.
Ada ukuran yang lebih sederhana tanpa pengkuadratan. Simpangan rata-rata mengambil jarak setiap nilai dari rata-rata, mengabaikan tanda minus, lalu merata-ratakannya. Untuk Tim B, jarak 3, 1, 1, 1, 0, 0, 2, dan 4 jumlahnya 12, dan 12 : 8 = 1,5. Ukuran ini lebih mudah dihitung dengan tangan, tetapi standar deviasi adalah ukuran yang menjadi dasar sebagian besar alat dan rumus statistik.
Berapa standar deviasi yang tergolong tinggi atau rendah?
Tidak ada satu angka pun yang menjadi patokan standar deviasi tinggi atau rendah. Semuanya bergantung pada besar nilai dan apa yang diukur. Standar deviasi 2 poin itu besar untuk skor kuis dari 10, tetapi sangat kecil untuk skor dari 1.000. Bandingkan dengan rata-rata dan dengan rentang nilai yang mungkin.
Contoh
Sekarang bandingkan Tim B dengan Tim A dari kuis yang sama.
- Tim A: 3, 5, 5, 5, 5, 5, 5, 7
- Tim B: 2, 4, 4, 4, 5, 5, 7, 9
Kedua tim memiliki rata-rata 5, karena setiap daftar berjumlah 40 dan 40 : 8 = 5. Namun skor Tim A berkumpul di sekitar 5, sedangkan skor Tim B tersebar dari 2 sampai 9. Standar deviasi Tim A adalah 1 poin, dan standar deviasi Tim B adalah 2 poin.
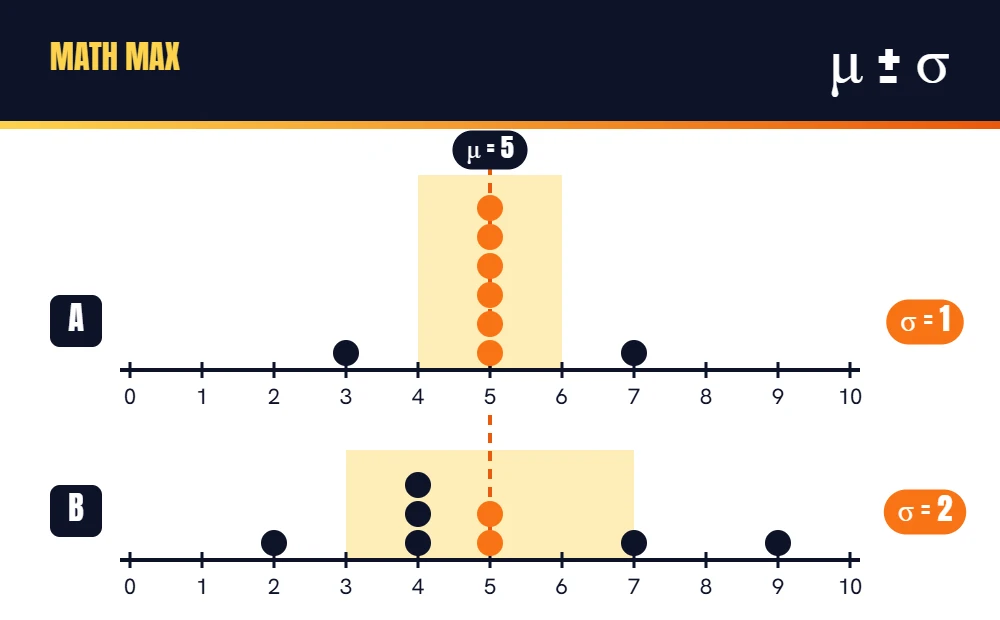
Jika hanya melihat rata-rata, kedua tim ini tampak sama persis. Standar deviasi menunjukkan bahwa Tim A sangat konsisten, sedangkan Tim B punya beberapa pemain yang jauh di depan dan beberapa yang jauh di belakang.
Contoh lain
Dua toko roti sama-sama menjual roti dengan berat rata-rata 500 g. Di toko pertama, standar deviasinya 5 g, jadi hampir setiap roti beratnya mendekati 500 g. Di toko kedua, standar deviasinya 40 g, jadi ada roti yang jelas lebih ringan dan ada yang lebih berat. Rata-ratanya sama, tetapi toko roti pertama jauh lebih konsisten.
Standar deviasi yang rendah tidak selalu lebih baik. Di kelas, standar deviasi yang tinggi pada hasil ulangan bisa saja hanya menunjukkan bahwa anak-anak berada di tahap yang sangat berbeda, dan itu berguna untuk diketahui guru. Di pabrik, standar deviasi yang rendah biasanya berarti mesinnya andal. Angka itu menggambarkan sebaran, dan konteksnya yang menentukan apakah sebaran itu kabar baik.
Standar deviasi tidak pernah bisa negatif, karena berasal dari akar kuadrat bilangan-bilangan yang dikuadratkan. Nilainya 0 hanya jika semua nilai sama.
Apa arti aturan 68-95-99,7?
Untuk data yang mengikuti distribusi normal, yaitu kurva lonceng yang sudah kita kenal, sekitar 68% nilai berada dalam jarak satu standar deviasi dari rata-rata. Sekitar 95% berada dalam jarak dua standar deviasi, dan sekitar 99,7% dalam jarak tiga. Ini disebut aturan empiris, dan aturan ini mengubah standar deviasi menjadi gambaran cepat tentang data.
Contoh
Misalkan waktu lari 1 km dalam kelompok besar mengikuti kurva lonceng dengan rata-rata 6 menit dan standar deviasi 1 menit. Maka sekitar 68% pelari selesai antara 5 dan 7 menit. Sekitar 95% selesai antara 4 dan 8 menit, dan hampir semua orang selesai antara 3 dan 9 menit.
Aturan ini hanya bekerja dengan baik untuk data berbentuk lonceng. Kelompok kecil, seperti kedua tim kuis tadi, jarang mengikutinya dengan tepat. Untuk data yang miring, seperti pendapatan atau waktu tunggu, rata-rata dan standar deviasi bisa memberi gambaran yang menyesatkan, dan median serta jangkauan sering kali lebih baik menggambarkan data.
Rata-rata adalah titik awal setiap standar deviasi, jadi menghitung rata-rata dengan cepat sangat membantu. Dalam permainan statistika, setiap serangan dalam pertarungan adalah soal statistika, jadi mencari rata-rata di kepala menjadi bagian dari memenangkan ronde. Ronde singkat yang sering lebih melatih kecepatan itu daripada satu sesi panjang.
Standar deviasi adalah jarak khas dari rata-rata
Standar deviasi menjawab satu pertanyaan. Seberapa jauh nilai yang khas dari rata-rata? Gunakan langkah-langkah ini setiap kali kamu perlu menghitungnya dengan tangan.
- Cari rata-ratanya.
- Kurangkan rata-rata dari setiap nilai.
- Kuadratkan setiap selisih.
- Jumlahkan kuadratnya.
- Bagi dengan N untuk seluruh populasi, atau dengan n − 1 untuk sampel.
- Tarik akar kuadratnya.
Hasil yang kecil berarti nilai-nilainya berdekatan, dan hasil yang besar berarti nilai-nilainya tersebar. Selalu baca hasilnya bersama rata-rata dan satuannya, karena sebaran hanya bermakna dalam konteksnya.
Latih ini berikutnya