標準偏差を順番に求めるにはどうすればよいですか?
標準偏差を求めるには、まず平均値を出し、それぞれの値から平均値を引きます。その差をそれぞれ2乗して、すべて足します。その合計を値の個数で割ると、分散が得られます。最後に、分散の平方根をとります。この結果が標準偏差で、元のデータと同じ単位で表されます。
例
8人ずつの2つのチームが、同じ10問のクイズに答えます。チームBを見てみましょう。得点は2、4、4、4、5、5、7、9です。
- 平均値を求めます。2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40、40 ÷ 8 = 5
- それぞれの値から平均値を引きます。−3、−1、−1、−1、0、0、2、4になります
- それぞれの差を2乗します。9、1、1、1、0、0、4、16になります
- 2乗した値を足します。9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- 値の個数で割ります。32 ÷ 8 = 4で、これが分散です
- 平方根をとります。√4 = 2なので、標準偏差は2です
同じ計算を値ごとに書くと、追いかけやすくなります。
- 2 − 5 = −3、(−3)² = 9
- 4 − 5 = −1、(−1)² = 1(3回)
- 5 − 5 = 0、0² = 0(2回)
- 7 − 5 = 2、2² = 4
- 9 − 5 = 4、4² = 16
差そのもの、つまり−3、−1、−1、−1、0、0、2、4を足すと0になることに注目してください。これはいつでも起こることで、2乗する理由もここにあります。くわしくは次の節で説明します。最後のステップでは平方根が必要です。平方根を何回か練習すると、頭の中でずっと早く見積もれるようになります。
標準偏差の公式は何ですか?
母集団の標準偏差は σ = √(Σ(x − μ)² ÷ N) です。ここで x はそれぞれの値、μ は平均値、N は値の個数、Σ は「すべて足し合わせる」という意味です。より大きな集団から取り出した標本の場合は、N ではなく n − 1 で割ります。こちらは s と書きます。
例
チームBが知りたい集団のすべてなら、N を使います。分散は 32 ÷ 8 = 4、σ = √4 = 2 です。
8人が学校全体を代表する標本として選ばれたのなら、n − 1 を使います。分散は 32 ÷ 7 ≈ 4.57、s = √4.57 ≈ 2.14 です。
標本ではなぜ n − 1 で割るのですか?
標本には、集団全体の中で最も極端な値の一部が含まれないことが多いため、散らばりが少し小さめに出やすくなります。少しだけ小さい数である n − 1 で割ると、結果が少し大きくなり、そのずれが補正されます。標本が大きくなると、2つの方法の差はごくわずかになります。
電卓や表計算ソフトには、両方の方法が用意されていることがよくあります。σ や「STDEV.P」と書かれたボタンや関数は N で割り、s や「STDEV.S」と書かれたものは n − 1 で割ります。先生や教科書がどちらを求めているか確認しましょう。どちらも、それぞれの場面では正しい方法です。
標準偏差ではなぜ差を2乗するのですか?
平均値からの差は、足すといつも0になります。平均より大きい値と小さい値がつり合うからです。2乗するとすべての差が正の数になるので、打ち消し合わなくなります。最後に平方根をとると、結果が元の単位に戻ります。そのため、点数の散らばりは点数で表されます。
例
チームBの差は−3、−1、−1、−1、0、0、2、4でした。合計は0なので、そのまま平均しても0になり、散らばりについては何もわかりません。2乗すると9、1、1、1、0、0、4、16になり、合計は32です。
2乗すると、平均から遠い値ほど大きな重みを持つようにもなります。NIST Engineering Statistics Handbookにわかりやすい説明があります。平均から2離れた点は合計に4を加えますが、10離れた点は100を加えます。そのため標準偏差は、ほかの人がよい点をとったグループの中に1人だけ0点がいるような、1つの極端な値に影響されやすくなります。
2乗を使わない、もっと簡単な指標もあります。平均絶対偏差は、それぞれの値と平均値との距離をとり、マイナスの符号を無視して平均したものです。チームBでは、距離3、1、1、1、0、0、2、4の合計が12で、12 ÷ 8 = 1.5です。手で計算するのは簡単ですが、多くの統計ツールや公式のもとになっているのは標準偏差です。
標準偏差が大きい、小さいとはどういうことですか?
標準偏差が大きいか小さいかを決める、ただ1つの基準となる数はありません。値の大きさや、何を測っているかによって変わります。標準偏差が2点というのは、10点満点のクイズなら大きいですが、1,000点満点なら小さなものです。平均値や、とりうる値の範囲と比べてみましょう。
例
では、同じクイズのチームBとチームAを比べてみましょう。
- チームA:3、5、5、5、5、5、5、7
- チームB:2、4、4、4、5、5、7、9
どちらのチームも平均値は5です。どちらのリストも合計が40で、40 ÷ 8 = 5だからです。しかし、チームAの得点は5のまわりに集まっているのに対し、チームBの得点は2から9まで散らばっています。チームAの標準偏差は1点、チームBは2点です。
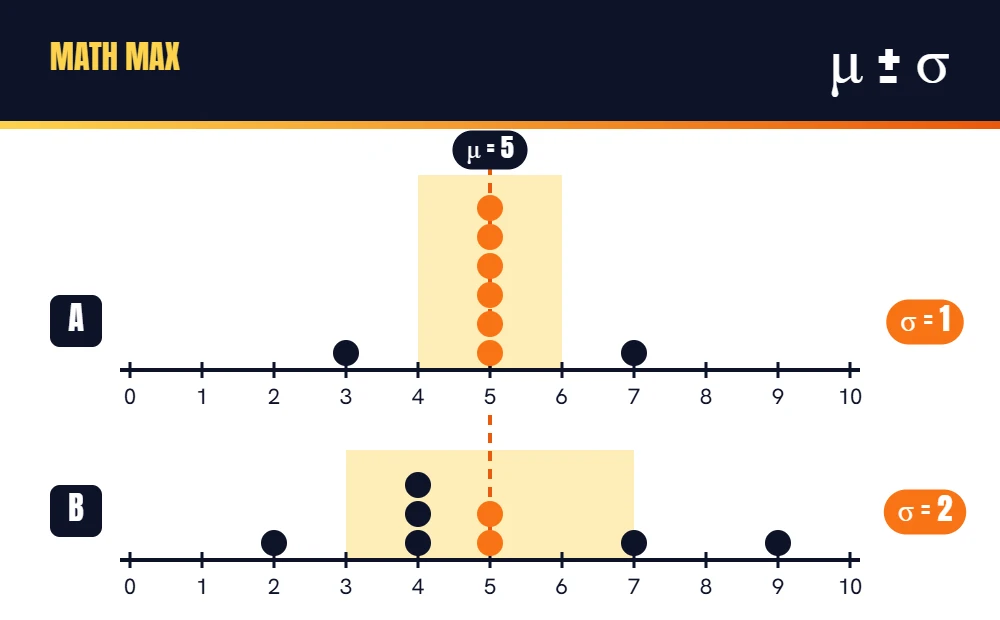
平均だけを見ると、2つのチームは同じに見えてしまいます。標準偏差を見ると、チームAはとても安定しているのに対し、チームBには大きく先を行く人と大きく遅れている人がいることがわかります。
別の例
2つのパン屋が、どちらも平均500 gのパンを売っています。1軒目の標準偏差は5 gなので、ほとんどのパンが500 gに近い重さです。2軒目は40 gなので、目に見えて軽いパンもあれば重いパンもあります。平均は同じですが、1軒目のほうがずっと安定しています。
標準偏差は小さいほうがよいとは限りません。教室では、テストの結果の標準偏差が大きいのは、子どもたちの学習の段階がそれぞれ大きく違うことを示しているだけかもしれません。これは先生にとって役に立つ情報です。工場では、標準偏差が小さいことはたいてい機械が安定していることを意味します。数値は散らばりを表し、その散らばりがよいことかどうかは状況によって決まります。
標準偏差が負になることはありません。2乗した数の平方根から求めるからです。標準偏差が0になるのは、すべての値が同じときだけです。
68-95-99.7則とはどういう意味ですか?
正規分布、つまりおなじみの釣鐘型の曲線に従うデータでは、値の約68%が平均から標準偏差1つ分の範囲に入ります。約95%は標準偏差2つ分、約99.7%は3つ分の範囲に入ります。これは経験則と呼ばれ、標準偏差からデータのようすをすばやく思い描けるようにしてくれます。
例
ある大きなグループで、1 km走のタイムが平均6分、標準偏差1分の釣鐘型の曲線に従うとします。すると、ランナーの約68%は5分から7分の間にゴールします。約95%は4分から8分の間にゴールし、ほぼ全員が3分から9分の間にゴールします。
この法則がうまく当てはまるのは、釣鐘型のデータだけです。2つのクイズチームのような小さなグループでは、ぴったり当てはまることはめったにありません。収入や待ち時間のように偏ったデータでは、平均値と標準偏差が誤解を招くことがあり、中央値や範囲のほうがデータをよく表すことが多くあります。
平均値はすべての標準偏差の出発点なので、平均をすばやく求められると役に立ちます。統計ゲームでは、バトルでの攻撃の1つ1つが統計の問題なので、頭の中で平均値を求めることがラウンドに勝つための一部になります。長い時間を1回やるより、短いラウンドを何度もくり返すほうが、そのスピードが身につきます。
標準偏差は平均からの典型的な距離
標準偏差が答えるのは、1つの問いです。典型的な値は、平均からどれくらい離れているのでしょうか。手で求めるときは、いつでも次の手順を使いましょう。
- 平均値を求めます。
- それぞれの値から平均値を引きます。
- それぞれの差を2乗します。
- 2乗した値を足します。
- 母集団全体ならNで、標本ならn − 1で割ります。
- 平方根をとります。
答えが小さければ値は近くに集まっていて、大きければ散らばっています。散らばりは状況の中でこそ意味を持つので、いつも平均値や単位と合わせて読み取りましょう。