표준편차는 어떻게 단계별로 계산하나요?
표준편차를 구하려면 먼저 평균을 구하고, 각 값에서 평균을 빼요. 그 차를 각각 제곱한 다음 제곱한 값을 모두 더해요. 그 합을 값의 개수로 나누면 분산이 나와요. 마지막으로 분산의 제곱근을 구해요. 그 결과가 표준편차이고, 원래 데이터와 같은 단위로 돌아와요.
예시
8명씩으로 이루어진 두 팀이 10문제짜리 같은 퀴즈를 풀어요. B팀을 살펴볼게요. 점수는 2, 4, 4, 4, 5, 5, 7, 9예요.
- 평균을 구해요. 2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40이고, 40 ÷ 8 = 5
- 각 값에서 평균을 빼요. 그러면 −3, −1, −1, −1, 0, 0, 2, 4가 나와요
- 각 차를 제곱해요. 그러면 9, 1, 1, 1, 0, 0, 4, 16이 나와요
- 제곱한 값을 더해요. 9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- 값의 개수로 나눠요. 32 ÷ 8 = 4이고, 이것이 분산이에요
- 제곱근을 구해요. √4 = 2이므로 표준편차는 2예요
같은 계산을 값 하나하나 따라가 보면 더 알기 쉬워요.
- 2 − 5 = −3이고, (−3)² = 9
- 4 − 5 = −1이고, (−1)² = 1, 세 번
- 5 − 5 = 0이고, 0² = 0, 두 번
- 7 − 5 = 2이고, 2² = 4
- 9 − 5 = 4이고, 4² = 16
차 자체, 즉 −3, −1, −1, −1, 0, 0, 2, 4를 모두 더하면 0이 된다는 점에 주목하세요. 이건 항상 그래요. 그리고 다음 절에서 보듯이 이것이 제곱하는 이유이기도 해요. 마지막 단계에는 제곱근이 필요한데, 제곱근을 몇 판 연습하면 머릿속으로 훨씬 빨리 어림할 수 있어요.
표준편차 공식은 무엇인가요?
모집단의 표준편차는 σ = √(Σ(x − μ)² ÷ N)이에요. 여기서 x는 각 값, μ는 평균, N은 값의 개수이고, Σ는 "모두 더한다"는 뜻이에요. 더 큰 집단에서 뽑은 표본이라면 N 대신 n − 1로 나눠요. 이 경우에는 s로 써요.
예시
B팀이 관심 있는 집단 전체라면 N을 써요. 분산은 32 ÷ 8 = 4이고, σ = √4 = 2예요.
8명이 학교 전체를 대표하도록 뽑힌 표본이라면 n − 1을 써요. 분산은 32 ÷ 7 ≈ 4.57이고, s = √4.57 ≈ 2.14예요.
표본에서는 왜 n − 1로 나누나요?
표본은 보통 전체 집단에서 가장 극단적인 값 몇 개를 놓치기 때문에, 흩어진 정도가 실제보다 조금 작게 나오기 쉬워요. 조금 더 작은 수인 n − 1로 나누면 결과가 조금 커져서 이 차이를 바로잡아요. 표본이 크면 두 방법의 차이는 아주 작아져요.
계산기와 스프레드시트에는 두 가지 방법이 모두 있는 경우가 많아요. σ나 "STDEV.P"라고 표시된 버튼이나 함수는 N으로 나누고, s나 "STDEV.S"라고 표시된 것은 n − 1로 나눠요. 선생님이나 교과서가 어느 쪽을 원하는지 확인하세요. 두 방법 모두 각자의 상황에서는 맞는 방법이에요.
표준편차에서는 왜 차를 제곱하나요?
평균과의 차를 모두 더하면 항상 0이 돼요. 평균보다 큰 값과 작은 값이 서로 균형을 이루기 때문이에요. 제곱하면 모든 차가 양수가 되어 더 이상 서로 상쇄되지 않아요. 마지막에 제곱근을 구하면 결과가 원래 단위로 돌아오기 때문에, 점수의 흩어짐은 점수로 나타나요.
예시
B팀의 차는 −3, −1, −1, −1, 0, 0, 2, 4였어요. 합이 0이라서 그대로 평균을 내도 0이 되고, 흩어진 정도에 대해서는 아무것도 알 수 없어요. 제곱하면 9, 1, 1, 1, 0, 0, 4, 16이 되고, 합은 32예요.
제곱하면 멀리 떨어진 값에 더 큰 무게가 실리기도 해요. NIST Engineering Statistics Handbook에 이를 잘 보여 주는 설명이 있어요. 평균에서 2만큼 떨어진 점은 합계에 4를 더하지만, 10만큼 떨어진 점은 100을 더해요. 그래서 표준편차는 다른 사람들은 모두 점수가 좋은 모둠에서 한 명만 0점을 받은 경우처럼, 극단적인 값 하나에도 민감하게 반응해요.
제곱을 건너뛰는 더 간단한 지표도 있어요. 평균절대편차는 각 값과 평균 사이의 거리를 구하고, 마이너스 부호를 무시한 채 그 평균을 내요. B팀의 경우 거리 3, 1, 1, 1, 0, 0, 2, 4를 더하면 12이고, 12 ÷ 8 = 1.5예요. 손으로 계산하기는 더 쉽지만, 대부분의 통계 도구와 공식은 표준편차를 바탕으로 만들어져 있어요.
표준편차가 크다, 작다는 어떻게 판단하나요?
표준편차가 크다 작다를 가르는 정해진 숫자는 없어요. 값의 크기와 무엇을 측정하는지에 따라 달라져요. 표준편차 2점은 10점 만점 퀴즈에서는 크지만, 1,000점 만점 점수에서는 아주 작아요. 평균, 그리고 나올 수 있는 값의 범위와 비교해 보세요.
예시
이제 같은 퀴즈에서 B팀과 A팀을 비교해 볼게요.
- A팀: 3, 5, 5, 5, 5, 5, 5, 7
- B팀: 2, 4, 4, 4, 5, 5, 7, 9
두 팀 모두 평균은 5예요. 각 목록의 합이 40이고 40 ÷ 8 = 5이기 때문이에요. 하지만 A팀의 점수는 5 주변에 모여 있고, B팀의 점수는 2부터 9까지 흩어져 있어요. A팀의 표준편차는 1점, B팀은 2점이에요.
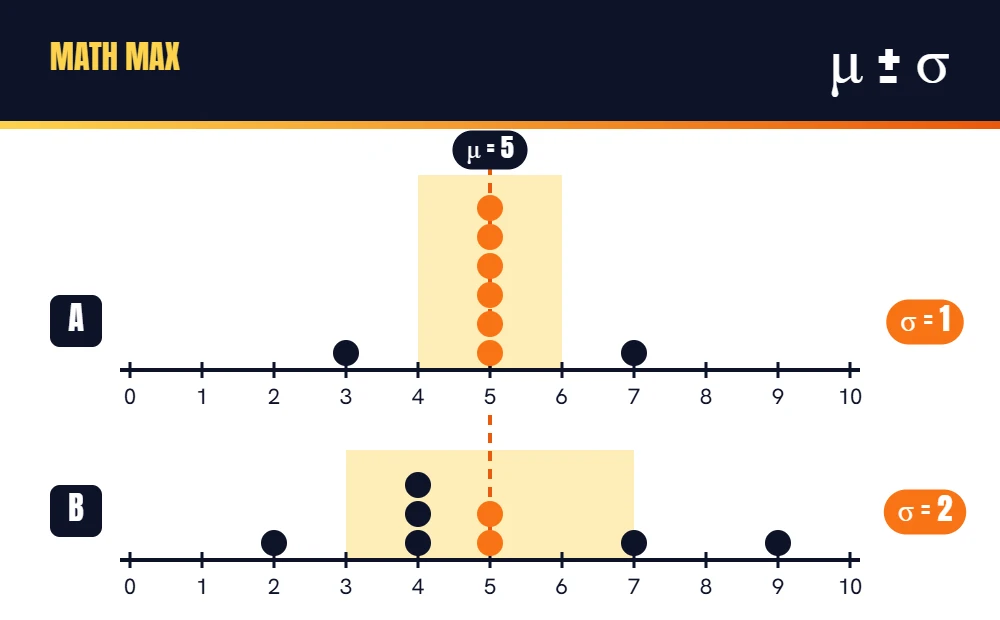
평균만 보면 두 팀이 똑같아 보여요. 표준편차를 보면 A팀은 매우 고른 반면, B팀에는 훨씬 앞선 선수도 있고 훨씬 뒤처진 선수도 있다는 걸 알 수 있어요.
또 다른 예시
두 빵집 모두 평균 무게가 500 g인 빵을 팔아요. 첫 번째 빵집의 표준편차는 5 g이라서 거의 모든 빵이 500 g에 가까워요. 두 번째 빵집은 40 g이라서 눈에 띄게 가벼운 빵도 있고 무거운 빵도 있어요. 평균은 같지만 첫 번째 빵집이 훨씬 고르게 만들어요.
표준편차가 작다고 항상 좋은 건 아니에요. 교실에서는 시험 결과의 표준편차가 크다는 것이 단지 아이들이 서로 아주 다른 단계에 있다는 뜻일 수 있고, 이는 선생님에게 유용한 정보예요. 공장에서는 표준편차가 작으면 보통 기계가 안정적으로 돌아간다는 뜻이에요. 숫자는 흩어진 정도를 설명할 뿐이고, 그 흩어짐이 좋은 소식인지는 상황이 결정해요.
표준편차는 절대 음수가 될 수 없어요. 제곱한 수의 제곱근에서 나오기 때문이에요. 모든 값이 같을 때만 0이 돼요.
68-95-99.7 규칙은 무슨 뜻인가요?
정규분포, 즉 익숙한 종 모양 곡선을 따르는 데이터에서는 값의 약 68%가 평균에서 표준편차 1개 범위 안에 있어요. 약 95%는 표준편차 2개 범위 안에, 약 99.7%는 3개 범위 안에 있어요. 이것을 경험 법칙이라고 하며, 표준편차 하나로 데이터의 모습을 빠르게 그려 볼 수 있게 해 줘요.
예시
큰 집단에서 1 km 달리기 기록이 평균 6분, 표준편차 1분인 종 모양 곡선을 따른다고 해 볼게요. 그러면 약 68%의 주자가 5분에서 7분 사이에 들어와요. 약 95%는 4분에서 8분 사이에 들어오고, 거의 모든 사람이 3분에서 9분 사이에 들어와요.
이 규칙은 종 모양 데이터에서만 잘 맞아요. 두 퀴즈 팀처럼 작은 집단은 이 규칙을 그대로 따르는 경우가 드물어요. 소득이나 대기 시간처럼 한쪽으로 치우친 데이터에서는 평균과 표준편차가 잘못된 인상을 줄 수 있고, 중앙값과 범위가 데이터를 더 잘 설명하는 경우가 많아요.
평균은 모든 표준편차의 출발점이라서 평균을 빨리 구할 수 있으면 도움이 돼요. 통계 게임에서는 대결의 공격 하나하나가 통계 문제라서, 머릿속으로 평균을 구하는 것이 라운드를 이기는 일의 일부가 돼요. 짧은 라운드를 자주 하는 것이 한 번에 오래 하는 것보다 속도를 키우는 데 더 좋아요.
표준편차는 평균으로부터의 전형적인 거리
표준편차는 한 가지 질문에 답해요. 전형적인 값은 평균에서 얼마나 떨어져 있을까요? 손으로 구해야 할 때는 언제든 다음 단계를 따르세요.
- 평균을 구해요.
- 각 값에서 평균을 빼요.
- 각 차를 제곱해요.
- 제곱한 값을 더해요.
- 모집단 전체라면 N으로, 표본이라면 n − 1로 나눠요.
- 제곱근을 구해요.
결과가 작으면 값들이 가까이 모여 있고, 크면 흩어져 있다는 뜻이에요. 흩어진 정도는 맥락 속에서만 의미가 있으니, 항상 평균과 단위와 함께 읽으세요.