Hvordan regner du ut standardavvik steg for steg?
For å regne ut standardavviket finner du gjennomsnittet, trekker det fra hver verdi, kvadrerer hver differanse og legger sammen kvadratene. Del summen på antall verdier, så får du variansen. Til slutt tar du kvadratroten av variansen. Resultatet er standardavviket, i samme enhet som de opprinnelige dataene.
Eksempel
To lag med 8 spillere svarer på den samme quizen med 10 spørsmål. Se på lag B, som fikk poengene 2, 4, 4, 4, 5, 5, 7 og 9.
- Finn gjennomsnittet. 2 + 4 + 4 + 4 + 5 + 5 + 7 + 9 = 40, og 40 : 8 = 5
- Trekk gjennomsnittet fra hver verdi. Det gir −3, −1, −1, −1, 0, 0, 2, 4
- Kvadrer hver differanse. Det gir 9, 1, 1, 1, 0, 0, 4, 16
- Legg sammen kvadratene. 9 + 1 + 1 + 1 + 0 + 0 + 4 + 16 = 32
- Del på antall verdier. 32 : 8 = 4, som er variansen
- Ta kvadratroten. √4 = 2, så standardavviket er 2
Den samme utregningen, verdi for verdi, gjør det lettere å holde oversikten.
- 2 − 5 = −3, og (−3)² = 9
- 4 − 5 = −1, og (−1)² = 1, tre ganger
- 5 − 5 = 0, og 0² = 0, to ganger
- 7 − 5 = 2, og 2² = 4
- 9 − 5 = 4, og 4² = 16
Legg merke til at selve differansene, −3, −1, −1, −1, 0, 0, 2 og 4, blir 0 til sammen. Det skjer alltid, og det forklarer hvorfor vi kvadrerer, slik neste del viser. Det siste steget krever en kvadratrot, og noen runder med kvadratrøtter gjør det mye raskere å anslå dem i hodet.
Hva er formelen for standardavvik?
Standardavviket for en populasjon er σ = √(Σ(x − μ)² : N). Her er x hver verdi, μ er gjennomsnittet, N er antall verdier, og Σ betyr «legg sammen alle». For et utvalg fra en større gruppe deler du på n − 1 i stedet for N. Den versjonen skrives s.
Eksempel
Hvis lag B er hele gruppen du er interessert i, bruker du N. Variansen er 32 : 8 = 4, og σ = √4 = 2.
Hvis de 8 spillerne er et utvalg som skal representere en hel skole, bruker du n − 1. Variansen er 32 : 7 ≈ 4,57, og s = √4,57 ≈ 2,14.
Hvorfor deler man på n − 1 for et utvalg?
Et utvalg mangler ofte noen av de mest ekstreme verdiene i hele gruppen, så spredningen blir gjerne litt for liten. Når du deler på n − 1, et litt mindre tall, blir resultatet litt større, og det retter opp dette. Med store utvalg blir forskjellen mellom de to versjonene svært liten.
Kalkulatorer og regneark har ofte begge versjonene. En knapp eller funksjon merket σ eller «populasjon» deler på N, og en merket s eller «utvalg» deler på n − 1. Sjekk hvilken læreren eller læreboka forventer, for begge er riktige i sin egen situasjon.
Hvorfor kvadrerer man differansene i standardavvik?
Differansene fra gjennomsnittet blir alltid null til sammen, fordi verdiene over gjennomsnittet veier opp for verdiene under. Når du kvadrerer, blir hver differanse positiv, så de opphever ikke lenger hverandre. Kvadratroten til slutt gir resultatet tilbake i den opprinnelige enheten, slik at en spredning i poeng måles i poeng.
Eksempel
For lag B var differansene −3, −1, −1, −1, 0, 0, 2 og 4. Summen er 0, så det vanlige gjennomsnittet av dem er også 0, og det sier ingenting om spredningen. Etter kvadreringen blir de 9, 1, 1, 1, 0, 0, 4 og 16, som blir 32 til sammen.
Kvadreringen gir også verdier langt unna mer vekt. NIST Engineering Statistics Handbook gir en tydelig illustrasjon. Et punkt 2 enheter fra gjennomsnittet legger til 4 i summen, mens et punkt 10 enheter unna legger til 100. Det gjør standardavviket følsomt for én enkelt ekstrem verdi, for eksempel én poengsum på 0 i en gruppe der resten gjorde det bra.
Det finnes et enklere mål som hopper over kvadreringen. Gjennomsnittlig absolutt avvik tar avstanden fra hver verdi til gjennomsnittet, ser bort fra minustegnene og finner gjennomsnittet av avstandene. For lag B blir avstandene 3, 1, 1, 1, 0, 0, 2 og 4 til sammen 12, og 12 : 8 = 1,5. Det er lettere å regne ut for hånd, men standardavviket er målet som de fleste statistikkverktøy og formler bygger på.
Hva er et høyt eller lavt standardavvik?
Det finnes ikke ett bestemt tall som regnes som et høyt eller lavt standardavvik. Det avhenger av hvor store verdiene er og hva de måler. Et standardavvik på 2 poeng er stort for quizpoeng av 10, men bitte lite for poeng av 1 000. Sammenlign det med gjennomsnittet og med spennet av mulige verdier.
Eksempel
Sammenlign nå lag B med lag A fra den samme quizen.
- Lag A: 3, 5, 5, 5, 5, 5, 5, 7
- Lag B: 2, 4, 4, 4, 5, 5, 7, 9
Begge lagene har gjennomsnitt 5, fordi hver liste blir 40 til sammen, og 40 : 8 = 5. Men poengene til lag A samler seg rundt 5, mens poengene til lag B er spredt fra 2 til 9. Standardavviket for lag A er 1 poeng, og for lag B er det 2 poeng.
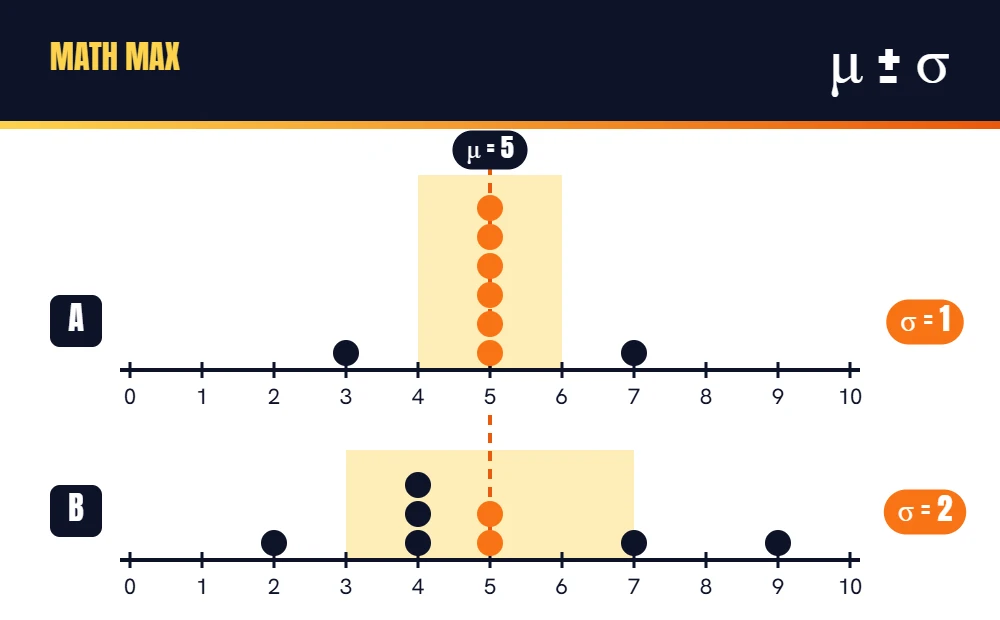
Gjennomsnittet alene ville fått lagene til å se like ut. Standardavviket viser at lag A er svært jevnt, mens lag B har noen spillere langt foran og noen langt bak.
Et eksempel til
To bakerier selger begge brød med en gjennomsnittsvekt på 500 g. Hos det første er standardavviket 5 g, så nesten hvert brød veier nær 500 g. Hos det andre er det 40 g, så noen brød er merkbart lettere og noen tyngre. Gjennomsnittene er like, men det første bakeriet er mye jevnere.
Et lavt standardavvik er ikke alltid bedre. I et klasserom kan et høyt standardavvik i prøveresultater ganske enkelt vise at barna har kommet svært ulikt, og det er nyttig for en lærer å vite. I en fabrikk betyr et lavt standardavvik vanligvis at maskinene er pålitelige. Tallet beskriver spredningen, og sammenhengen avgjør om spredningen er gode nyheter.
Et standardavvik kan aldri være negativt, fordi det kommer fra en kvadratrot av kvadrerte tall. Det er 0 bare når alle verdiene er like.
Hva betyr 68-95-99,7-regelen?
For data som følger en normalfordeling, den kjente klokkeformede kurven, ligger omtrent 68 % av verdiene innenfor ett standardavvik fra gjennomsnittet. Omtrent 95 % ligger innenfor to standardavvik, og omtrent 99,7 % innenfor tre. Dette kalles den empiriske regelen, og den gjør et standardavvik om til et raskt bilde av dataene.
Eksempel
Tenk deg at tidene på et 1 km-løp i en stor gruppe følger en klokkekurve med gjennomsnitt 6 minutter og standardavvik 1 minutt. Da kommer omtrent 68 % av løperne i mål mellom 5 og 7 minutter. Omtrent 95 % kommer i mål mellom 4 og 8 minutter, og nesten alle kommer i mål mellom 3 og 9 minutter.
Regelen fungerer bare godt for klokkeformede data. Små grupper, som de to quizlagene, følger den sjelden nøye. For skjeve data, som inntekter eller ventetider, kan gjennomsnittet og standardavviket gi et misvisende bilde, og medianen og variasjonsbredden beskriver ofte dataene bedre.
Gjennomsnittet er utgangspunktet for hvert standardavvik, så det hjelper å kunne regne ut gjennomsnitt raskt. I statistikkspillet er hvert angrep i en kamp et statistikkspørsmål, så å finne et gjennomsnitt i hodet blir en del av å vinne en runde. Korte, hyppige runder bygger opp farten bedre enn én lang økt.
Standardavviket er den typiske avstanden fra gjennomsnittet
Standardavviket svarer på ett spørsmål. Hvor langt fra gjennomsnittet ligger en typisk verdi? Bruk disse stegene når du skal finne det for hånd.
- Finn gjennomsnittet.
- Trekk gjennomsnittet fra hver verdi.
- Kvadrer hver differanse.
- Legg sammen kvadratene.
- Del på N for en hel populasjon, eller på n − 1 for et utvalg.
- Ta kvadratroten.
Et lite svar betyr at verdiene ligger tett sammen, og et stort svar betyr at de er spredt utover. Les det alltid sammen med gjennomsnittet og enheten, for en spredning gir bare mening i sammenhengen.
Tren disse videre